Kong 是由 Kong Inc.(原 Mashape)开源的高性能云原生 API 网关与微服务管理层。它构建在 Nginx 与 OpenResty 之上,基于 LuaJIT 提供高吞吐、低延迟的流量代理与可扩展的插件体系。
典型互联网 App 全链路接入架构与网关定位
在深入探讨 Kong 等具体 API 网关的底层实现与插件生态之前,有必要先建立对现代大型互联网系统(如电商、社交、超级 App 等工业级高并发场景)端到端全链路接入架构的全局认知。
在真实的生产环境中,从用户的手机屏幕点击,到内网微服务集群执行业务逻辑,中间绝非简单的“客户端直连反向代理”。为了应对数亿移动用户、千万级并发长连接、DDoS 攻击清洗以及异地多活(单元化)流量调度,整个接入体系是由端侧智能调度、物理网络、四七层分流、安全风控、长连通道、业务网关、服务发现与内网高性能 RPC 构成的完整工业级流水线。
工业级全链路架构全景
核心名词与术语表
为了帮助清晰理解上述工业级全链路架构图中的分层概念与技术选型,下表对链路中涉及的核心概念、标准缩写、主要职责以及业界代表性实现进行了归纳:
| 术语 / 缩写 | 全称 / 标准定义 | 链路位置与核心职责 | 业界代表产品 / 实现方案 |
|---|---|---|---|
| HTTPDNS | 基于 HTTP 的域名解析服务 (HTTP-based DNS) | 端侧调度:绕过传统运营商递归 LocalDNS,防止域名劫持与 LocalDNS 跨省缓存污染,为客户端秒级返回就近机房的最优接入 Anycast IP。 | 阿里云 AMDC、腾讯云 DNSPod、华为云 HTTPDNS |
| Anycast VIP | 任播虚拟 IP 地址 (Anycast Virtual IP) | 网络路由:基于 BGP Anycast 协议,使全球多个数据中心共享同一公网 VIP,骨干路由器自动将客户端流量路由至地理上最近的接入机房。 | Cloudflare Anycast、各大云厂商公网接入点 |
| CDN | 内容分发网络 (Content Delivery Network) | 边缘缓存:专门面向静态资源(图片、JS/CSS、安装包、短视频)进行边缘就近缓存;动态 API 业务请求通常直接绕过 CDN 进数据中心。 | Cloudflare、Akamai、阿里云 CDN、AWS CloudFront |
| L4 LB | 四层负载均衡器 (Layer-4 Load Balancer) | 入口抗并发:工作在传输层(TCP/UDP),基于连接做哈希转发(如 ECMP)。只管握手与包分发,不做应用层解析,承接千万级长短连接高并发。 | Linux LVS、DPDK、Keepalived、AWS NLB |
| Keepalived | VRRP 协议高可用服务守护进程 (Keepalived) | 4层高可用容灾:与 LVS / 软负载深度结合,通过 VRRP 虚拟路由冗余协议对负载均衡节点健康探活与故障漂移(Failover),确保 VIP 永不宕机。 | Keepalived、ECMP 动态路由冗余 |
| WAF | Web 应用防火墙 (Web Application Firewall) | 安全与风控:深入七层报文进行 CC 攻击清洗、SQL 注入拦截、爬虫高频嗅探识别与人机滑块动态验证,将恶意请求在入口前直接熔断。 | 阿里霸下、AWS WAF、Cloudflare WAF、ModSecurity |
| ALB / Ingress | 应用型负载均衡 / 统一接入层 (App Load Balancer) | 接入网关:统一的物理网络入口,负责全站公网 TLS 证书终结卸载、HTTP/HTTPS 统一域名分发、多活容灾与单元化机房切流。对业务语义透明。 | Tengine (AServer)、Envoy、AWS ALB、K8s Ingress Nginx |
| Push Channel | 移动端双向长连通道 (Mobile Push Channel) | 网络通道:移动端 App 后台常驻的单条持久连接(HTTP/2 或 QUIC),支持极低功耗双向推送(交易/聊天消息),并负责客户端私有二进制协议解包。 | 阿里 ACCS、腾讯双向通道、gRPC 双向流 (Bidirectional Streaming) |
| API Gateway | 业务 API 网关 (Business API Gateway) | 业务治理中枢:API 契约看门人,负责 API 语义路由、移动端防篡改签名验签、统一 Session/Token 鉴权、细粒度限流熔断与协议转码。 | Kong Gateway、Apache APISIX、阿里 MTOP、Spring Cloud Gateway |
| Service Registry | 微服务注册与发现中心 (Service Registry) | 服务拓扑感知:后端微服务实例 Pod 动态上下线、心跳探活与注册,向网关和 RPC 客户端实时下发健康可用的服务实例 IP 列表。 | Nacos、Consul、Eureka、Kubernetes CoreDNS |
| RPC Engine | 远程过程调用引擎 (Remote Procedure Call Engine) | 内网服务通信:微服务间基于二进制高效协议通信;网关通过**泛化调用(Generic Invoke)**将 HTTP 请求直接转为内网二进制 RPC,大幅降低损耗。 | Apache Dubbo、gRPC、阿里 HSF、Thrift |
全链路中的五个关键基础设施角色
在现代大型互联网与云原生架构中,除常见的四/七层流量网关外,全链路中还穿插着五个至关重要的底层基础设施与中间件角色(以业界通用标准与典型工业级实践为例):
- 端侧智能调度:动态 HTTPDNS / 调度中心 (如 AMDC / DNSPod)
- 位置:位于客户端发起网络请求的最前端(App 启动及周期性后台更新)。
- 作用:基于 HTTPDNS 协议的客户端动态调度中心。它绕过了传统运营商 LocalDNS 的域名解析劫持、缓存污染与跨网解析延迟问题,直接向客户端返回当前网络拓扑下最优的接入 IP(Anycast VIP)列表,并指示当前用户请求应当定向到哪一个就近机房或可用区单元(Unit)。动静分离路径:对于高频的动态业务 API 请求,客户端拿到机房 VIP 后直接与数据中心 4 层负载均衡(L4 LB)建连,无需经过 CDN;CDN 专门服务于静态资源(图片、前端资源、短视频)的就近边缘缓存加速。
- 四层高并发负载均衡:4层软负载集群 / L4 LB (如 LVS / DPDK / NLB)
- 位置:位于客户端 API 直连与 CDN 静态资源回源的物理数据中心入口处,处于七层 WAF / 应用接入网关之前。
- 作用:七层代理(如 Nginx/Envoy)解析完整 HTTP 协议并做 TLS 加解密计算开销极大。在七层集群前,必须部署基于 DPDK / Linux LVS 的高性能四层软负载,专门负责承接数千万级的并发 TCP 握手与连接保活,通过 ECMP / 一致性哈希将网络报文均匀分发给后端的七层集群物理机。
- 移动端双向长连通道:长连接通道服务 (如 ACCS / gRPC 双向流)
- 位置:与统一接入层 / ALB 深度集成的端到端持久化信道。
- 作用:移动端 App 在后台运行时,频繁发起 HTTP 短连接握手开销极大。长连通道通过 HTTP/2 / QUIC 维持与服务端的单条多路复用 TCP/UDP 长连接通道,支持极低延迟的双向消息推送(如交易状态变更、物流推送)与二进制自定义协议解包,解包后的标准请求再平滑送入业务网关。
- 服务发现与命名中心:服务注册中心 / Service Registry (如 Nacos / Consul / Eureka)
- 位置:位于业务 API 网关与后端微服务集群之间。
- 作用:充当分布式系统内部的服务注册中心。业务网关知道一个 API 需要转发给后端微服务(如
item-service),但该服务动态部署在底层 Kubernetes 的哪几千个 Pod 容器上?网关通过服务注册中心动态订阅健康的 IP:Port 实例列表,并在网关进程内部完成软负载均衡与故障节点秒级剔除。
- 内网高性能通信协议:RPC 通信引擎 (如 Dubbo / gRPC / HSF)
- 位置:业务 API 网关调用内网业务 Pod 的通信通道。
- 作用:网关往内网微服务调用时,通常不再走性能较低的 HTTP 协议,而是直接走内网 RPC。网关利用 RPC 引擎的**泛化调用(Generic Invoke)**能力,将前端传入的 JSON 或键值参数直接在内存中序列化为目标服务对应的二进制 RPC 报文,直连后端微服务,大幅降低内网网络传输耗时与序列化 CPU 损耗。
为什么在全链路中不可缺少 API Gateway?
回顾上述链路,很多工程师会产生一个疑问:既然前面已经有四层负载均衡(LVS/NLB)做了高并发抗流,又有七层统一接入网关(如 ALB/Tengine)做了 TLS 卸载和机房路由,为什么系统内部还必须独立设置一道业务 API Gateway(如 Kong、APISIX)?
这是因为 接入网关(如 ALB / Ingress Controller) 与 业务网关(API Gateway,如 Kong / APISIX / MTOP) 在系统演进中解决的是截然不同维度的核心问题:
- 网络层基础设施与应用层治理的关注点分离:
- 统一接入层 / ALB(接入网关):属于底层网络基础设施,专注于物理连接管理、全站统一域名路由、TLS 握手卸载以及单元化机房切流。它对具体业务语义是无感知、透明的。
- API Gateway(业务网关):属于应用治理中枢,专注于业务合规与应用交互契约。它需要深度解析 API 语义、解析用户鉴权 Token、校验客户端请求签名(防重放与防篡改)、提取调用方上下文(User ID / Device ID)并注入内网微服务调用链。
- 端到端协议转换器(Protocol Adapter):
- 客户端面对公网,首选松耦合、跨平台、便于调试的 RESTful HTTP/HTTPS、JSON 或 gRPC-Web;
- 内网成千上万个微服务为了极限吞吐与强契约约束,普遍采用基于 TCP 的私有二进制 RPC 协议(Dubbo / gRPC / HSF)。
- API Gateway 充当了全链路上的协议适配中枢,通过泛化调用桥接了外网 HTTP 与内网 RPC,避免各个业务微服务把 RPC 端口直接暴露到公网,也使微服务接口演进与外网 API 版本完全解耦。
- 业务级防刷与精细化限流防线:
- 四七层网络接入设备通常只能根据客户端 IP 速率做粗粒度的流量整形(无法防范黑产分布式 IP 代理池攻击);
- API Gateway 拥有完整的用户身份与业务上下文,可以根据 用户 ID、移动端 AppKey、商户 ID、具体 API 接口 实施细粒度的分布式滑动窗口限流、热点参数限流(如特定秒杀商品 ID)以及精准熔断降级。
- 微服务拓扑的抽象与安全防线:
- 如果没有 API Gateway,前端 App 必须知道每一个业务微服务的地址,导致内网拓扑完全暴露在公网,任何内部服务重构都会导致 App 接口中断;
- API Gateway 为外网屏蔽了复杂的内部微服务网络拓扑,后端无论如何拆分、聚合、迁移或重命名服务,网关对外呈现的始终是稳定不变的标准 API 界面。
概述与核心定位
在微服务架构和云原生体系中,API 网关位于客户端与后端服务之间,扮演着统一入口与流量看门人的角色。它的核心价值在于将所有后端服务共性的非功能性需求(横切关注点,Cross-Cutting Concerns)从业务代码中下沉并统一管控,使后端微服务只需聚焦于核心业务逻辑。
API 网关核心能力矩阵
现代 API 网关(如 Kong Gateway)主要涵盖以下 9 大核心功能:
| 核心能力 | 网关职责与价值 | Kong 实现机制 / 关联实体与插件 |
|---|---|---|
| 负载均衡 (Load Balancing) | 在后端多实例间分发流量,避免单点过载 | Upstream 与 Target 实体,支持权重轮询(Round-Robin)、一致性哈希(Consistent-Hashing)与最少连接 |
| 路由 (Routing) | 接收客户端请求并基于特征精准反向代理至后端 | Route + Service 实体,基于 Host、Path、Method、Headers 多维规则匹配,支持 HTTP/HTTPS、gRPC、WebSockets、TCP/UDP |
| SSL / TLS 证书管理 | 统一管理证书、卸载加密计算(SSL Termination)与双向 mTLS | Certificate 与 SNI 实体,在 certificate() 阶段按域名动态握手,支持 Let’s Encrypt 自动化运维(acme 插件) |
| 缓存 (Caching) | 缓存高频且不常变的数据,直接在网关响应,保护后端 | proxy-cache 插件,基于 Method、Path、Header 缓存响应体,显著降低后端压力与响应延迟 |
| 请求与响应转换 (Transformation) | 解耦前后端数据格式、抹平协议差异与敏感数据清洗 | request-transformer 与 response-transformer 插件,在转发前后动态修改 Header、Query、Body;支持 gRPC 转码 |
| 限流与熔断 (Rate Limiting & Circuit Breaking) | 防突发流量打垮系统,故障实例自动切流隔离 | 限流使用 rate-limiting(支持本地/Redis/集群多策略);熔断依赖 Upstream 的被动健康检查(Passive Health Checks)与故障剔除 |
| 安全与鉴权 (Security & Auth) | 统一身份认证、权限校验、防跨域与网络边界防护 | 认证插件(key-auth、jwt、oauth2)、访问控制(ip-restriction 黑白名单)、安全头注入(cors)与 WAF 防护 |
| 监控与日志 (Observability) | 全局流量透明化、链路追踪与故障快速定界 | 指标暴露(prometheus)、分布式追踪(opentelemetry / zipkin)、访问日志异步流转(http-log / file-log) |
| 版本管理 (Versioning & Traffic Splitting) | 多版本 API 共存、蓝绿部署与金丝雀平滑灰度切流 | 路由规则分流(基于 Path /v1、/v2 或 Header X-API-Version),配合 canary 插件与 Upstream 权重渐进式放量 |
核心架构与运行机制
架构全景:控制面与数据面
Kong 的架构在设计上解耦了控制面(Control Plane, CP)与数据面(Data Plane, DP):
- 控制面(Control Plane):负责接收运维和开发人员的配置变更(通过 Admin API 或声明式配置文件),将元数据持久化并下发给各数据面节点。
- 数据面(Data Plane):运行在生产流量路径上的 Kong 实例,负责接收客户端请求、执行插件链逻辑并反向代理至上游后端服务。
两种部署模式:DB 模式 vs DB-less 模式
| 模式 | 存储介质 | 配置生效方式 | 适用场景 |
|---|---|---|---|
| 传统 DB 模式 | PostgreSQL / Cassandra | 运行时通过 Admin API 写入数据库,节点通过轮询机制同步到本地共享内存 | 传统虚拟机/容器环境、需要动态通过 REST API 增删改路由的场景 |
| DB-less 模式 | 无外置数据库(内存存储) | 通过 kong.yml 声明式文件加载,或结合 decK / Kubernetes Ingress Controller (KIC) 动态同步 | GitOps 流程、Kubernetes 云原生集群、极简高可用架构 |
底层机制:OpenResty 基石与 Kong 的进化
Kong 的高性能并不是凭空而来的,它的底层基石是 OpenResty(Nginx + LuaJIT)。理解 OpenResty 的核心架构机制以及 Kong 在此之上的技术跃迁,是深入掌握 Kong 运行原理的关键。
OpenResty 核心架构机制
OpenResty 本质上是以 Nginx 核心为网络容器、将 LuaJIT 深度嵌入的高性能 Web 与网关开发平台,其核心技术由以下四大要素构成:
- Nginx 事件驱动核心:采用经典的 Master-Worker 多进程模型。单 Master 负责管理配置与子进程,多个 Worker 内部依托 Linux
epoll或 BSDkqueue实现事件驱动的高并发 I/O 多路复用,内存占用低且具备极强的进程隔离稳定性。 - ngx_lua 阶段执行模型:OpenResty 将 Nginx 处理 HTTP 请求的底层状态机细分为多个有序的 Hook 阶段(如
init_worker、ssl_certificate、rewrite、access、content、header_filter、body_filter、log),允许在请求生命周期的精准时点注入 Lua 业务逻辑。 - Cosocket 协程化非阻塞 I/O:这是 OpenResty 最核心的技术突破。开发者可以使用直观、同步的写法调用网络 I/O(如
httpc:request_uri(...)或访问 Redis/MySQL),底层却利用 Lua 协程(Coroutine)在遇到 I/O 阻塞时自动yield出让 CPU,交还给 Nginx epoll 事件循环;当网络数据到达时再通过resume唤醒协程继续执行。既消灭了异步回调地狱(Callback Hell),又保留了 Nginx 原生的超高并发性能。 - 进程间共享内存(
lua_shared_dict):Nginx Worker 进程彼此内存独立,OpenResty 提供了基于红黑树和 LRU 淘汰队列的高性能共享内存字典,支持跨多 Worker 进程进行无锁原子操作、高频配置缓存与限流计数。
Kong 在 OpenResty 基础上做了什么
原生 OpenResty 是一个强大但偏底层的运行平台,若直接将其用作企业级 API 网关,开发者必须自行手写海量 Lua 脚本、手动维护路由树、硬编码鉴权逻辑并自行处理进程同步。Kong 在 OpenResty 之上完成了从底层 Web 框架向工业级 API 网关平台的全面跃迁:
- 运行时零重载(Zero-Reload 热生效):传统 Nginx/OpenResty 的路由配置通常硬编码在静态
nginx.conf中,每次配置变更必须执行nginx -s reload,在高并发生产集群中会导致连接中断与瞬时性能抖动。Kong 创新性地构建了mlcache(多级缓存系统:Worker 本地 L1 缓存 +lua_shared_dictL2 共享内存 + 数据库 L3) 与worker-events进程间事件总线,所有配置的增删改查均在运行时内存级同步生效,实现真正的零重启、零 reload、毫秒级热加载。 - 动态实体抽象与关系建模:将 Nginx 物理网络配置(
server/location/upstream)解耦为面向云原生的逻辑实体体系(Service、Route、Upstream、Target、Consumer、Plugin、Certificate),支持 REST API 动态管控。 - 可插拔插件生命周期与编排引擎:在 OpenResty 的各阶段 Hook 之上,构建了统一的 Plugin 调度执行链。支持按
PRIORITY优先级自动排序、支持全局/服务/路由/消费者层级的细粒度绑定与继承覆盖,并提供kong.response.exit等安全短路熔断机制。 - 标准化开发者 PDK(Plugin Development Kit):将底层裸露、晦涩且易踩坑的
ngx.*变量与请求上下文封装为面向 API 网关的高阶面向对象接口(kong.service.*、kong.request.*、kong.response.*、kong.log.*等),抹平底层技术复杂度,并进一步扩展至多语言 Sidecar 进程(Go / Python / JS PDK)。 - 应用级动态负载均衡与健康检查熔断器:突破了 Nginx 原生静态 upstream 限制,在应用层实现了动态环形负载均衡器(Ring Balancer),支持动态权重轮询、一致性哈希,并内建主动探活(Active Health Check)与故障实例被动断路熔断(Circuit Breaker)。
- 控制面与数据面解耦(CP / DP 体系):支持集群化大规模演进,不仅支持传统数据库持久化(PostgreSQL/Cassandra),还支持声明式 GitOps(decK)以及云原生 Kubernetes Ingress(KIC)部署。
技术分层演进全景
核心配置文件 kong.conf 与关键参数解析
Kong 在启动时会加载核心配置文件 kong.conf(默认位于 /etc/kong/kong.conf,或由环境变量 KONG_CONF 指定)。此外,所有以 KONG_ 前缀开头的环境变量都会无缝覆盖 kong.conf 中的同名配置项(例如环境变量 KONG_DATABASE=postgres 对应配置文件中的 database = postgres)。
下面按功能模块深入拆解生产环境最核心的配置参数:
基础网络监听与端口绑定
# ==============================================================================
# 1. 网络监听与接口暴露 (Networking & Ports)
# ==============================================================================

# 数据面 (Data Plane):对外承接客户端生产业务请求的接入端口
# 格式: <ip>:<port> [ssl] [http2] [proxy_protocol]
proxy_listen = 0.0.0.0:8000 reuseport backlog=16384, 0.0.0.0:8443 ssl http2 reuseport backlog=16384

# 控制面 (Control Plane):管理人员/CI 运维使用的 Admin API 监听端口
# 生产强烈建议绑定内网私有 IP (如 127.0.0.1 或内网网卡),切勿暴露给公网!
admin_listen = 127.0.0.1:8001, 127.0.0.1:8444 ssl

# 混合部署集群监听 (Cluster Listen):控制面向数据面下发配置的 mTLS 通信端口 (默认 8005)
cluster_listen = 0.0.0.0:8005

# 探活与状态监控端口 (Status Listen):Prometheus 抓取或 K8s liveness/readiness 探针专用
status_listen = 0.0.0.0:8100
部署拓扑与存储模式 (Deployment & Database)
# ==============================================================================
# 2. 部署拓扑与元数据存储 (Database & Clustering)
# ==============================================================================

# 运行角色模式:
# - traditional: 传统单体/对等模式 (同时承担 Admin API 和 Proxy 流量)
# - control_plane: 独立控制面 (仅接收配置,不承接业务流量)
# - data_plane: 独立数据面 (仅转发流量,从 CP 实时拉取配置,无需连接数据库)
role = traditional

# 元数据存储后端:
# - postgres: 连接 PostgreSQL 关系数据库
# - off: 无数据库模式 (DB-less),纯内存运行,通过声明式 YAML (decK) 加载配置
database = postgres

# PostgreSQL 数据库连接池与凭证配置
pg_host = 127.0.0.1
pg_port = 5432
pg_database = kong
pg_user = kong
pg_password = kong_secret_pass
pg_pool_size = 30                    # 每个 Nginx Worker 与数据库的最大连接数
pg_timeout = 5000                    # 数据库操作超时阈值 (毫秒)
Nginx 底层与系统性能调优
# ==============================================================================
# 3. Nginx 进程模型与性能调优 (System & Performance)
# ==============================================================================

# Nginx Worker 进程数:
# 生产推荐设为 auto (自动对齐物理 CPU 核心数,充分利用多核亲和性)
nginx_worker_processes = auto

# 每个 Worker 允许建立的最大并发连接数 (ulimit -n 须同步调大)
# 总理论并发能力 = nginx_worker_processes * nginx_worker_connections
nginx_worker_connections = 10240

# Nginx 主工作目录与运行时生成物临时存放路径
prefix = /usr/local/kong/

# 进程属主用户与用户组
nginx_user = kong kong
共享内存与 DNS 动态解析调优
# ==============================================================================
# 4. 共享内存字典与 DNS 上游解析 (Memory & DNS Resolver)
# ==============================================================================

# 路由与实体配置在内存缓存中的容量大小 (mlcache L2 共享内存区)
# 生产环境中若 Service/Route/Consumer/Plugin 数量达到万级,应调大至 256m ~ 512m
mem_cache_size = 128m

# 上游服务域名动态解析服务器 (默认读取容器内 /etc/resolv.conf)
# 在 Kubernetes 中建议填入 kube-dns / CoreDNS 集群 IP (如 10.96.0.10)
dns_resolver = 10.96.0.10:53, 8.8.8.8:53

# DNS 解析记录缓存时间 (秒):
# 若设为 off 则严格遵循 DNS 记录自带的 TTL;生产环境设为 30s 可防 DNS 抖动
dns_stale_ttl = 30
插件加载与安全管控
# ==============================================================================
# 5. 插件加载、安全与全链路追踪 (Plugins & Tracing)
# ==============================================================================

# 预加载插件列表 (白名单制):
# - bundled: 加载 Kong 官方自带的所有官方插件
# - 自定义插件须追加在列表末尾 (逗号分隔),如: bundled,my-custom-auth,rate-limiter
plugins = bundled,custom-audit-log

# 生产环境请求注入与追踪追踪头
# 是否向上游透传 X-Kong-Proxy-Latency (网关内部处理耗时) 与 X-Kong-Upstream-Latency
headers = latency_tokens, server_tokens

# 限制网关允许接收的客户端请求体最大限制 (等效 client_max_body_size)
client_max_body_size = 20m

# 诊断与运行日志级别: debug, info, notice, warn, error, crit (生产建议 notice 或 warn)
log_level = notice
核心实体与流量模型
Kong 的路由系统围绕一组核心实体构建,各实体之间的关联与流量流向如下:
[ 客户端请求 Client ]
        │
        ▼
   [ Route (路由匹配规则) ]
        │
        ▼
   [ Service (后端服务抽象) ]
        │
        ▼
   [ Upstream (负载均衡集群) ] ── (按权重/轮询分发) ──► [ Target: Backend IP:Port ]
核心实体解析
- Service(服务):对上游真实后端 API 的抽象定义,包含协议(protocol)、域名/主机名(host)、端口(port)、基础路径(path)等属性。
- Route(路由):客户端请求进入网关时的匹配规则。一个 Service 可以挂载多个 Route。当请求的
hosts、paths、methods、headers等匹配 Route 定义时,该请求将被转发至对应的 Service。 - Upstream(上游集群):对应后端一组承载相同业务的服务器集群,负责负载均衡(Round-Robin、Consistent-Hashing 等)与高可用容灾。内置两种健康检查机制以实现节点级故障熔断(Circuit Breaking):
- 主动健康检查(Active Health Checks):网关后台定期向 Target 发送探测探针(如
GET /healthz),根据预设连续成功/失败次数自动标记节点可用性。 - 被动健康检查(Passive Health Checks / 断路器):实时监测生产真实业务流量。当某个 Target 连续返回指定 HTTP 错误码(如 500、502、503)或 TCP 超时达阈值时,网关立即触发断路熔断,将其标记为
unhealthy并摘除流量;在经过设定的静默恢复期后,放行少量请求探活(半开恢复状态)。
- 主动健康检查(Active Health Checks):网关后台定期向 Target 发送探测探针(如
- Target(目标实例):Upstream 中的具体服务节点(IP/域名 + 端口 + 权重)。当后端实例宕机或被健康检查判定异常时,会自动从负载均衡池中剔除。
- Certificate & SNI(证书与域名绑定):管理 SSL/TLS 证书(公钥证书与私钥)。通过关联 SNI(Server Name Indication),网关在 TLS 握手阶段动态匹配并返回相应域名的证书,实现单 IP 托管多域名的 SSL 卸载、动态证书加载与双向认证(mTLS)。
- Consumer(消费者):代表调用 API 的客户端或用户。通过与认证插件(如 Key-Auth、JWT)配合,可对特定调用方进行身份识别、独立限流与权限控制。
- Plugin(插件):注入到请求生命周期中的功能模块。插件可以绑定在不同层级:
- Global:全局生效,作用于所有流经网关的请求。
- Service 级:仅对特定后端服务生效。
- Route 级:仅对特定路由规则生效。
- Consumer 级:仅对特定用户生效。
核心操作与配置方式
使用 Admin API 管理实体
Admin API 默认监听在 8001(HTTP)或 8444(HTTPS)端口,提供标准的 RESTful 接口。
创建 Service
curl -i -X POST http://localhost:8001/services \
  --data name=user-service \
  --data url=http://upstream-user-backend:8080/api/v1
创建 Route
为 user-service 创建路由,将匹配 /users 路径的请求转发过去:
curl -i -X POST http://localhost:8001/services/user-service/routes \
  --data name=user-route \
  --data "paths[]=/users" \
  --data "strip_path=false"
配置 Upstream 与 Target
实现动态负载均衡与健康检查:
# 创建 Upstream
curl -i -X POST http://localhost:8001/upstreams \
  --data name=user-backend-pool

# 添加 Target 实例
curl -i -X POST http://localhost:8001/upstreams/user-backend-pool/targets \
  --data target="10.0.1.10:8080" \
  --data weight=100

curl -i -X POST http://localhost:8001/upstreams/user-backend-pool/targets \
  --data target="10.0.1.11:8080" \
  --data weight=100
随后将 user-service 的 host 字段更新为 user-backend-pool 即可将流量接入负载均衡池。
声明式配置与 decK
在 DB-less 或 GitOps 模式下,使用 kong.yaml 集中声明所有网关配置:
_format_version: "3.0"

services:
  - name: order-service
    url: http://order-api:8080
    routes:
      - name: order-route
        paths:
          - /orders
        strip_path: false
        plugins:
          - name: rate-limiting
            config:
              minute: 100
              policy: local

consumers:
  - username: app-client-01
    keyauth_credentials:
      - key: secret-api-key-123456
通过官方工具 decK 执行差异比对(diff)与平滑同步(sync):
# 验证配置合法性
deck validate -s kong.yaml

# 比较当前网关运行态与配置文件的差异
deck diff -s kong.yaml

# 将配置同步推送到网关
deck sync -s kong.yaml
常用插件体系
Kong 官方与社区提供了数十种插件,覆盖 API 全生命周期的治理需求:
认证与安全(Authentication & Security)
key-auth:API Key 认证,客户端通过 Header(如apikey: xxx)或 Query 参数传递密钥。jwt:解析并校验 JSON Web Token 签名与有效时间(exp、nbf),免去后端重复验签开销。oauth2:将 Kong 作为 OAuth 2.0 授权服务器或资源服务器,支持多种授权流程与 Token 验证。ip-restriction:基于白名单(whitelist)或黑名单(blacklist)阻断或放行客户端 IP 流量。cors:自动处理浏览器跨域预检请求(OPTIONS)并注入标准 CORS 响应头。acme:对接 Let’s Encrypt 等 ACME 协议 CA 机构,全自动申请、配置与无感续期 SSL/TLS 证书。
流量控制与高可用(Traffic Control & Resilience)
rate-limiting:基于秒/分/小时维度的速率限制。支持三种计数器存储策略:local:单机内存计数,性能最高但集群间不共享配额。redis:借助 Redis 集中存储计数器,适用于多节点精确限流。cluster:依赖 Kong 数据库聚合(DB 模式可用)。
response-ratelimiting:根据后端返回的自定义 Header 执行动态限流。proxy-cache:根据请求 Method、Path、Header 缓存后端响应内容,降低上游服务压力。
数据与协议转换(Transformation)
request-transformer:在请求转发给上游后端之前,动态添加、替换、重命名或删除 Header、Query 参数及 JSON 请求体字段。response-transformer:在响应返回给客户端之前,动态修改响应头(如安全脱敏、注入自定义 Header)或改写响应体字段。grpc-web/grpc-gateway:支持浏览器端通过 gRPC-Web 调用后端,或在网关层完成 RESTful JSON 与 gRPC 协议互转。
灰度发布与版本管理(Traffic Splitting & Versioning)
- 路由级版本管理:利用 Route 规则按 Path(如
/api/v1vs/api/v2)或 Header(如X-API-Version: v2)将多版本 API 流量解耦路由至不同的 Service。 canary:金丝雀灰度发布插件。支持在同一个 Route 下,按照设定的百分比(如 5% $\rightarrow$ 20% $\rightarrow$ 100%)、特定白名单用户(Consumer)或特定 Header 将生产流量平滑切流到新版本 Upstream 服务中,保障发布安全。
监控与可观测性(Observability)
prometheus:暴露标准 Prometheus 格式指标端点(请求延迟分位数、状态码计数、带宽吞吐、Upstream 健康状态)。zipkin/opentelemetry:生成符合 OpenTelemetry / W3C TraceContext 规范的分布式追踪链路,自动注入traceparent上下文头。file-log/http-log/tcp-log:将结构化访问日志异步输出至磁盘或通过 HTTP/TCP 流转至 ELK、Loki 等日志分析系统。
插件执行生命周期
Kong 插件的执行流程与 OpenResty(Nginx)的处理阶段深度绑定。开发者或使用者理解执行生命周期,对于分析请求流程和编写自定义 Lua 插件至关重要。
生命周期阶段对照表
| OpenResty 阶段 | Kong 插件 Hook 接口 | 执行时机与职责 | 典型操作 |
|---|---|---|---|
init_worker | init_worker() | Nginx Worker 进程启动时触发 | 初始化定时器、后台拉取数据、创建连接池 |
ssl_certificate | certificate() | SSL/TLS 握手阶段 | 动态读取证书、根据 SNI 匹配自定义证书 |
rewrite | rewrite() | 接收到请求头部,路由匹配前执行 | 全局重定向、修改原始 URL、早期流量切分 |
access | access() | 路由匹配完成,转发上游之前执行(最核心阶段) | 身份认证(JWT/Key-Auth)、鉴权、黑白名单、限流拦截 |
header_filter | header_filter() | 接收到上游返回的所有响应头 | 增删改 Response Header(如 CORS、安全头注入) |
body_filter | body_filter() | 接收到上游返回的响应体数据块(流式 chunk) | 响应体内容脱敏、修改、追加数据 |
log | log() | 请求完全响应客户端后异步执行 | 统计耗时、记录日志、上报 Prometheus 指标 |
插件执行优先级(Priority)
每个插件定义中都包含一个整型数值 PRIORITY。在同一执行阶段(例如 access 阶段):
- 高优先级插件优先执行:例如认证插件(
jwt,Priority 通常约为1005)优先于限流插件(rate-limiting,Priority 约为901)执行。 - 安全短路机制:如果在前置插件中调用了
kong.response.exit(401, ...)终止请求,后续插件的access阶段将不再执行,直接跳转至header_filter和log阶段。
自定义插件开发实战
除了官方提供的内置插件,Kong 提供了高度可扩展的插件开发体系。开发者既可以使用 Lua 编写与 Nginx 进程同生命周期的原生插件,也可以借助 Sidecar 进程机制使用 Go 等通用编程语言编写插件。完整可运行的本地演练环境与示例源码可参考 GitHub 仓库:qtopie/kong-workshop。
插件项目目录结构
一个标准 Lua 插件遵循特定的目录层级规范(以 demo 插件为例):
kong-plugin-demo/
├── demo-1.0.0-1.rockspec       # LuaRocks 包构建描述与模块导出定义
└── kong/
    └── plugins/
        └── demo/
            ├── schema.lua      # 插件参数定义与校验规则
            └── handler.lua     # 插件生命周期 Hook 与核心逻辑实现
demo-1.0.0-1.rockspec:声明插件包名、版本、依赖及 Lua 模块与实际源码路径的映射。schema.lua:定义插件在 Admin API 或声明式配置文件中可接收的配置项,包含字段类型、默认值、必填项与联合校验。handler.lua:实现各生命周期阶段的 Hook 函数,通过 Kong PDK(Plugin Development Kit)操作请求与响应。
插件配置模式(schema.lua)
schema.lua 利用 Kong 内置的模式校验器(kong.db.schema.typedefs),对用户传入的插件参数执行严谨的静态与动态校验:
local typedefs = require "kong.db.schema.typedefs"

-- 动态提取当前插件名称(kong.plugins.demo -> demo)
local plugin_name = ({...})[1]:match("^kong%.plugins%.([^%.]+)")

local schema = {
  name = plugin_name,
  fields = {
    -- 绑定约束:声明该插件不能绑定到 Consumer(常用于仅服务/路由生效的插件)
    { consumer = typedefs.no_consumer },
    { protocols = typedefs.protocols_http },
    { config = {
        type = "record",
        fields = {
          -- 自定义请求头名称,内置 header_name 类型校验
          { request_header = typedefs.header_name {
              required = true,
              default = "Hello-World" } },
          -- 自定义响应头名称
          { response_header = typedefs.header_name {
              required = true,
              default = "Bye-World" } },
          -- 整型配置项与数值约束(必须大于 0)
          { ttl = {
              type = "integer",
              default = 600,
              required = true,
              gt = 0, } },
        },
        entity_checks = {
          -- 跨字段联合约束:校验两个 Header 名称不能相同
          { distinct = { "request_header", "response_header" } },
        },
      },
    },
  },
}

return schema
核心逻辑实现(handler.lua 与 PDK)
在 handler.lua 中,通过挂载各阶段 Hook 介入请求处理流程,并调用 Kong 官方提供的 PDK(如 kong.service.request.*、kong.response.*)以及 OpenResty ngx.* API:
local plugin = {
  PRIORITY = 1000, -- 决定同阶段插件执行优先级(数值越大越先执行)
  VERSION = "1.0.0",
}

-- Worker 进程启动初始化
function plugin:init_worker()
  kong.log.debug("Plugin worker initialized")
end

-- 访问控制与请求改写阶段(最常用阶段)
function plugin:access(plugin_conf)
  -- 1. 改写发往上游后端的请求头
  kong.service.request.set_header("Accept-Encoding", "identity")
  kong.service.request.set_header(plugin_conf.request_header, "custom-value")

  -- 2. 动态灰度路由:依据特定 Header 动态切流到指定 Upstream
  local track = kong.request.get_header("track")
  if track and track == "canary" then
    local ok, err = kong.service.set_upstream("canary-upstream-pool")
    if not ok then
      kong.log.err("failed to route to canary upstream: ", err)
      return kong.response.exit(500, { message = "Canary routing failed" })
    end
  end
end

-- 响应头过滤阶段
function plugin:header_filter(plugin_conf)
  -- 注入自定义响应头
  kong.response.set_header(plugin_conf.response_header, "processed-by-kong")
  -- 动态修改响应体前清除 Content-Length,防止长度不匹配导致客户端截断
  kong.response.clear_header("Content-Length")
end

-- 响应体流式过滤阶段(Chunk 分块重写或包装统一响应)
function plugin:body_filter(plugin_conf)
  local ctx = ngx.ctx
  local chunk, eof = ngx.arg[1], ngx.arg[2]

  ctx.rt_body_chunks = ctx.rt_body_chunks or {}
  ctx.rt_body_chunk_count = (ctx.rt_body_chunk_count or 0) + 1

  if eof then
    -- 上游响应完全接收完毕,合并所有分块并包裹为标准统一 JSON 响应
    local complete_body = table.concat(ctx.rt_body_chunks)
    ngx.arg[1] = '{"code":0,"msg":"success","data":' .. complete_body .. '}'
  else
    -- 暂存流式分块,阻断当前分块直接输出
    ctx.rt_body_chunks[ctx.rt_body_chunk_count] = chunk
    ngx.arg[1] = nil
  end
end

-- 访问日志与异步监控上报阶段
function plugin:log(plugin_conf)
  local latency = kong.response.get_latencies()
  kong.log.debug("Request total latency: ", latency.kong)
end

return plugin
插件打包、安装与加载
打包与本地安装
在插件根目录下使用 LuaRocks 工具链完成本地构建与打包:
# 本地编译并验证
luarocks make --local

# 打包为通用 rock 文件
luarocks pack demo 1.0.0-1

# 安装到本地环境(默认位于 ~/.luarocks)
luarocks install demo-1.0.0-1.all.rock --local
在 kong.conf 中启用插件
在 Kong 配置文件 kong.conf(或通过环境变量 KONG_PLUGINS)将自定义插件追加到白名单中:
# 保留官方内置插件(bundled)并追加 demo
plugins = bundled, demo
修改后重启或平滑重载 Kong 节点使配置生效:kong restart 或 kong reload。
通过 Admin API 绑定插件
将自定义插件应用到具体的 Service 或 Route:
curl -i -X POST http://localhost:8001/services/user-service/plugins \
  --data "name=demo" \
  --data "config.request_header=X-App-Trace" \
  --data "config.response_header=X-App-Handled"
多语言插件支持机制(以 Go Plugin 为例)
Kong 2.0+ 引入了多语言插件开发套件(PDK),允许开发者使用 Go、Python、JavaScript 等通用语言编写网关插件:
- 架构运行机制:Kong 并未在 Nginx Worker 内部直接嵌入 Go 运行时,而是通过 Sidecar 独立常驻子进程(
go-pluginserver) 配合 Unix Domain Socket 进行进程间高性能 IPC 通信。 - Go PDK:官方提供
github.com/Kong/go-pdk,接口设计与 Lua PDK 保持高度一致。 - Kong 配置挂载:在
kong.conf中声明 Go 插件服务器及 Socket 路径:pluginserver_names = go pluginserver_go_socket = /usr/local/kong/go_pluginserver.sock pluginserver_go_start_cmd = go-pluginserver -kong-prefix /usr/local/kong/ -plugins-directory /usr/local/kong/go-plugins pluginserver_go_query_cmd = go-pluginserver -dump-all-plugins -plugins-directory /usr/local/kong/go-plugins - 技术选型权衡:
- Lua 原生插件:与 Nginx/OpenResty 处于同一进程空间,内存零拷贝,性能最高、延迟最低(亚毫秒级),适合对吞吐与延迟极其敏感的核心网关治理逻辑。
- 多语言插件(Go/Python 等):跨进程 UDS 通信带来轻微上下文切换损耗,但能够直接复用现有业务语言技术栈与成熟 SDK,适合复杂业务判定与跨平台生态集成。
生产实践与性能调优
数据库缓存与 Worker 同步调优
在 DB 模式下,合理设置配置缓存时间可有效降低数据库负载:
db_update_frequency(默认 5s):Worker 轮询数据库检查配置版本的时间间隔。生产环境若变更较少,可适度增大(如 10s–30s)。db_cache_ttl(默认 0,永不过期):实体缓存在共享内存中的存活时间。结合 Kong 内部缓存事件失效机制,保持为 0 可获得最佳命中率。
上游 Keepalive 连接池复用
如果未启用长连接池,Kong 对上游后端的每次反向代理都会经历 TCP 三次握手与四次挥手,在高并发场景下会导致大量 TIME_WAIT 连接与端口耗尽:
# 调整 kong.conf 配置参数
upstream_keepalive_pool_size = 512
upstream_keepalive_max_requests = 10000
upstream_keepalive_idle_timeout = 60s
同时确保上游后端服务配置了合理的 keepalive_timeout。
DNS 解析与负载均衡缓存
Kong 默认使用内置的异步 DNS 解析器:
dns_hostsfile/dns_resolver:明确配置高可用的内网 DNS 服务器。dns_stale_ttl:当 DNS 服务器暂时无法连通时,允许使用过期解析结果的时间,保障极端网络抖动下的业务连续性。
日志异步化与非阻塞 I/O
- 避免在核心链路(
access/header_filter)执行同步阻塞的 I/O 操作(如阻塞式网络请求、复杂同步写盘)。 - 日志收集建议优先采用基于内存缓冲的异步上报插件(如
http-log配合queue缓冲参数),防止远程日志系统抖动拖垮网关转发性能。
实战案例:高频动态配置更新下的内存泄漏诊断(基于火焰图)
在网关生产运维中,最棘手的问题莫过于内存缓慢增长但无法释放(Memory Leak)。本案例基于开源实战仓库 qtopie/kong-workshop(参见 kong-memory-leak/ 目录)复现并深度排查,其对应的是官方著名的 Kong Issue #6547 内存泄漏缺陷:
问题现象与压测复现
在混合部署(Hybrid Mode,CP/DP 分离)场景下,控制面通过 Admin API 频繁更新路由或服务实体:
# 模拟 CI/CD 自动化部署或灰度切流:高频持续更新 Service 配置
hey -z 15m -m PUT -T 'application/json' \
  -d '{"host":"test-backend"}' \
  "http://<kong-cp-ip>:8001/services/<service-uuid>"
压测期间,数据面(Data Plane)的 Nginx Worker 进程 RES 物理内存一路飙升数 GB,且执行完整的 LuaJIT 垃圾回收(collectgarbage("collect"))后内存依然无法回落,直至触发 Linux OOM Killer 强杀 Worker。
诊断利器:动态追踪与火焰图定位
排查 OpenResty / Kong 的内存暴涨,传统的 gdb、top 或基础 heap dump 难以直接透视 LuaJIT 虚拟机的内部对象分配。必须借助基于 SystemTap / OpenResty X-Ray / eBPF 的无侵入运行时动态追踪技术,分别抓取 LuaJIT 虚拟机层 与 C 语言运行时层 的内存分配火焰图。
火焰图采样与抓取实战流程
以基于 openresty-systemtap-toolkit 与 stapxx 的排查流程为例,抓取火焰图的标准步骤如下:
环境准备与内核符号安装
SystemTap 需要通过内核及被测二进制的调试符号(debug symbols)来展开调用栈:
# 安装 SystemTap 及依赖工具链
sudo apt-get install -y systemtap systemtap-sdt-dev linux-image-$(uname -r)-dbgsym linux-headers-$(uname -r)

# 克隆 OpenResty 官方 SystemTap 工具集与 FlameGraph 绘图工具
git clone https://github.com/openresty/openresty-systemtap-toolkit.git /usr/local/openresty-systemtap-toolkit
git clone https://github.com/openresty/stapxx.git /usr/local/stapxx
git clone https://github.com/brendangregg/FlameGraph.git /usr/local/FlameGraph

export PATH=$PATH:/usr/local/openresty-systemtap-toolkit:/usr/local/stapxx:/usr/local/FlameGraph
抓取 LuaJIT GC 对象分配火焰图 (Lua-Land)
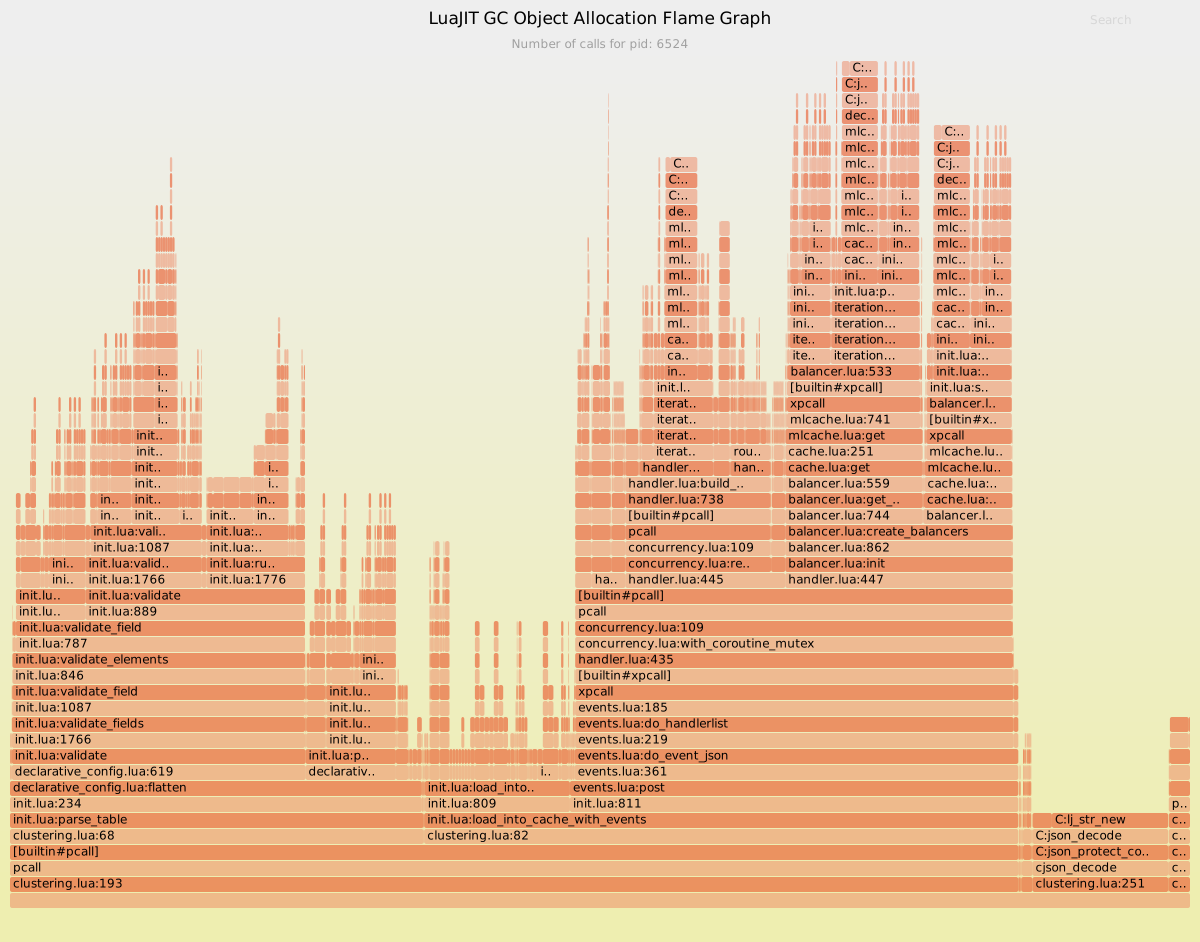
使用 ngx-lj-gc-objs 脚本无侵入挂载到目标 Nginx Worker 进程,采样其在 LuaJIT 堆中创建新 GC 对象(追踪 lj_mem_newgco 与 lj_str_new)的完整调用栈:
# 获取当前内存异常增长的 Nginx Worker 进程 PID
PID=$(pgrep -f "nginx: worker process" | head -n 1)

# 采样 30 秒内的 LuaJIT GC 内存分配事件
./ngx-lj-gc-objs -p $PID --luajit20 -t 30 > lj-gc-objs.bt

# 转换采样调用栈并生成交互式 SVG 火焰图
stackcollapse-stap.pl lj-gc-objs.bt | flamegraph.pl \
  --title "LuaJIT GC Object Allocation Flame Graph" \
  --countname "allocations" > kong-luajit-gc-flamegraph.svg
抓取 C 级别内存分配火焰图 (C-Land)
使用 sample-bt-leaks 追踪 glibc 的 malloc、posix_memalign 及 Nginx 内存池 ngx_palloc,排查 C 层堆内存分配:
# 抓取 30 秒内的 C 语言内存分配调用栈
./sample-bt-leaks -p $PID -t 30 > c-alloc.bt

# 生成 C 语言内存分配火焰图
stackcollapse-stap.pl c-alloc.bt | flamegraph.pl \
  --title "C Memory Allocation Flame Graph" \
  --countname "bytes" > kong-c-memory-flamegraph.svg
采样产物展示与对比
LuaJIT GC 对象分配火焰图 (Lua-Land Flame Graph)
通过上述命令抓取到的 Lua 级内存对象分配火焰图如下:
C 级别内存分配火焰图 (C-Land Flame Graph)
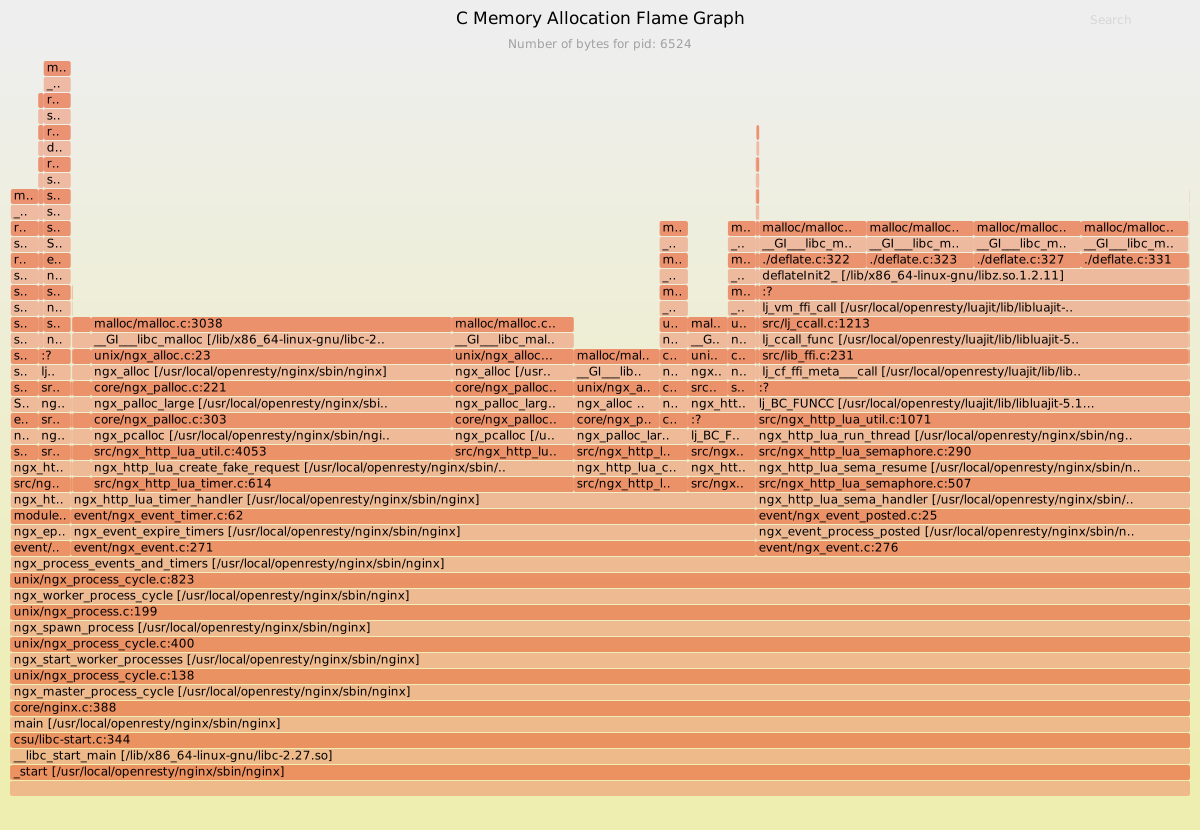
通过追踪 glibc 与 Nginx 内存池抓取到的 C 级别内存分配火焰图如下:
根本原因深度剖析 (Root Cause Analysis)
对照上述两张火焰图及调用栈数据,可精准还原内存泄漏的底层链条:
- 调用栈热点溯源:
- 观察
LuaJIT-GC-Object-Allocation-Flame-Graph可以发现,横向跨度最大的热点路径完全聚集在:clustering.lua$\rightarrow$init.lua:load_into_cache_with_events$\rightarrow$events.lua:post$\rightarrow$events.lua:do_handlerlist$\rightarrow$concurrency.lua:with_coroutine_mutex$\rightarrow$balancer.lua:init / rebuild_router$\rightarrow$mlcache.lua:get$\rightarrow$cjson_decode。
- 观察
- CP/DP 事件循环闭环与闭包残留:
- 在 Hybrid 模式下,控制面(CP)向数据面(DP)持续推送实体更新事件(
events.lua); - 数据面每收到一次配置变更,就会触发路由器和负载均衡器的重建逻辑(
rebuild_router与create_balancers); - 在重建过程中,Kong 使用
mlcache跨 Worker 共享内存拉取并反序列化实体。然而,在当时版本的集群事件订阅机制中,每次事件派发都会创建新的回调闭包(Closure),且该闭包向上持有了全局事件调度上下文的强引用; - 尽管高频产生的旧 Router/Balancer 实体已被废弃,但由于全局事件监听链表(
events.lua:handlerlist)未能及时清理失效的解绑函数,导致整棵依赖树中的大量短生命周期 Luatable与字符串被长期强引用固定在 LuaJIT 根集(Root Set)中; - LuaJIT 的两色/三色 GC 标记清除算法认为这些对象仍处在活跃可达状态,因此无论触发多少次全量垃圾回收,内存均无法被真正释放,Worker 进程内存线性暴增直至 OOM。
- 在 Hybrid 模式下,控制面(CP)向数据面(DP)持续推送实体更新事件(
什么是 Upvalue?(Lua 闭包核心概念)
在深入排查之前,必须先理解 Lua / LuaJIT 中独特的 Upvalue(外部局部变量) 概念:
- 定义:当一个内部函数(或匿名函数)访问了其外层函数的局部变量,且该内部函数脱离了外层函数的作用域独立存在(即形成了闭包
Closure)时,被捕获的这个外层局部变量就称为 Upvalue。 - 物理存储与生命周期跃迁(Open $\rightarrow$ Closed):
- Open 状态:在外层函数还在执行时,局部变量分配在栈(Stack)上,内部闭包通过指针直接引用栈上的变量槽位;
- Closed 状态:一旦外层函数执行完毕返回,栈帧即将销毁。LuaJIT 虚拟机为了保证闭包后续仍能正常访问该变量,会自动将这个局部变量从栈上「复制/跃迁」到堆(Heap)上独立的 Upvalue 对象中,并由该闭包独占强引用;
- 为什么 Upvalue 会成为内存泄漏的「致命隐患」?
- 只要持有 Upvalue 的闭包本身可达,其引用的 Upvalue 变量所指向的整棵对象树(哪怕包含数百万个 Table、函数、字符串),就永远属于 GC Root 可达路径,哪怕创建它的外层函数早就执行完毕、对应的局部变量名也早已离开作用域!
闭包内存泄漏的代码机理深度还原
为了直观理解「闭包将大对象作为 Upvalue 强引用固化在堆上,导致无法 GC」的机制,我们将 Kong 缺陷源码的核心逻辑抽象为以下代码模型:
-- 1. 全局单例的事件注册中心 (长生命周期,映射真实 Kong 中的 kong.events.sub / resty.events 机制)
local _M = {}
local event_handlers = {} -- 全局回调列表: event_handlers[event_name] = { fn1, fn2, ... }

-- 订阅事件函数 (模拟 Kong 底层的事件注册)
function _M.subscribe(event_name, callback)
  event_handlers[event_name] = event_handlers[event_name] or {}
  table.insert(event_handlers[event_name], callback)

  -- 返回一个用于解除订阅的函数
  return function()
    -- 缺陷所在: 早期版本在 unsubscribe 时未彻底清空引用,或上层未主动调用
  end
end

-- 2. 每次配置刷新时执行的实体加载器 (短生命周期,本应在更新后被 GC 回收)
function reload_service_router(new_config_payload)
  -- 在局部作用域分配一个巨大的上下文数据结构 (包含解析后的整个路由树与 Upstream 表)
  local heavy_context = {
    payload = new_config_payload,     -- 巨大的 JSON/Table 树
    router  = build_heavy_router(),  -- 路由器解析树
    timestamp = os.time(),
  }

  -- 【问题发生点】:创建了一个匿名函数,并注册到全局单例的 event_handlers 中
  -- 匿名函数内部访问了外层局部变量 heavy_context,触发 LuaJIT 捕获机制:
  -- heavy_context 成为该闭包的 Upvalue!
  local unhook = _M.subscribe("cluster:entity_update", function(data)
    -- 此匿名闭包内部访问了 heavy_context,成为其绑定的 Upvalue!
    if heavy_context.router then
      heavy_context.router:update(data)
    end
  end)

  -- reload_service_router 函数执行完毕并退出...
  -- 【堆栈跃迁】:外层函数栈帧销毁,LuaJIT 将 heavy_context 从栈复制到堆上的 Upvalue 结构中;
  -- 【期望】:heavy_context 随外层函数执行结束而被释放;
  -- 【现实】:
  --   全局 GC 根集 _G.event_handlers
  --           │ (强引用)
  --           ▼
  --      匿名闭包 (Closure)
  --           │ (持有 Closed Upvalue 强引用)
  --           ▼
  --     heavy_context (包含几万个路由对象与字符串)
  -- 只要全局 event_handlers 未解绑该闭包,整棵 heavy_context 永远处于强引用可达状态!
end
通俗直白的大白话总结: 用一句话概括这个 Bug 的本质:存在一个全局长寿的“订阅器 Map”(事件表),每次 reload 时都会往里面塞入新的闭包对象,但由于历史闭包从未被清理或解绑,Map 变成了「只进不出」的黑洞;更致命的是每个闭包都暗中死死拽住了当次 reload 构造的全量庞大上下文(Upvalue),导致成千上万个历史版本的全量路由大对象全部无法被 GC 回收,最终打爆内存。
为什么执行 collectgarbage("collect") 也无效?
LuaJIT 的垃圾回收器采用**标记-清除(Mark-and-Sweep)算法,从全局环境 _G 以及所有注册在全局单例中的数据表作为根集(GC Root)**出发遍历可达对象。只要事件中心的 event_handlers 全局数组还保存着该闭包,闭包绑定的 Upvalue(即包含完整路由和 Upstream 实体树的 heavy_context)就永远被标为「活跃可达(Alive)」。当 Admin API 每秒持续更新几十次时,内存中就会残留成千上万个孤儿 Upvalue 上下文,造成每分钟数百兆的物理内存刚性泄漏。
经典 Patch 案例研判:声明式配置中的 Schema 重复编译与 Reload 隐患
在排查与修复此类内存与 GC 问题时,Kong 官方在 kong/db/schema/others/declarative_config.lua 中曾提交过一个非常经典的修复补丁(Commit: bebd483):
@@ -621,11 +621,13 @@ local function flatten(self, input)
    -- the error may be due entity validation that depends on foreign entity,
    -- and that is the reason why we try to validate the input again with the
    -- filled foreign keys
    if not self.full_schema then
      self.full_schema = DeclarativeConfig.load(self.plugin_set, true)
    end
    local input_copy = utils.deep_copy(input, false)
    populate_ids_for_validation(input_copy, self.known_entities)
-   local schema = DeclarativeConfig.load(self.plugin_set, true)
-   local ok2, err2 = schema:validate(input_copy)
+   local ok2, err2 = self.full_schema:validate(input_copy)
    if not ok2 then
      local err3 = utils.deep_merge(err2, extract_null_errors(err))
      return nil, err3
为什么这个 Patch 能够立竿见影?
- 修正「写了缓存却漏用」的逻辑缺陷:
- 代码上方原本明确编写了缓存逻辑:
if not self.full_schema then self.full_schema = DeclarativeConfig.load(...) end; - 但原代码在下方真正执行外键校验时,却硬生生再次调用了
DeclarativeConfig.load(self.plugin_set, true),导致缓存被完全架空;
- 代码上方原本明确编写了缓存逻辑:
- 阻断巨型对象树的重复编译:
DeclarativeConfig.load会遍历加载当前核心实体与所有启用插件,为每个字段动态构建复杂的 Schema 校验规则树、大量的验证闭包及元表(Metatable);- 在包含大量外键依赖(如 Service、Route、Consumer 相互引用)的复杂配置中,单次
flatten流程内该分支会被频繁触发;未打补丁前,每次触发都会在堆上凭空生成一套全新的巨型 Schema,引发严重的内存颠簸; - 补丁改为直接复用
self.full_schema:validate(input_copy),将整个解析生命周期内的构建次数压减至最多 1 次。
深入追问:如果系统发生 Reload,这里还会出问题吗?
维度一:Schema 规则会不会脏读或过期?
- 不会。 在 Kong 中,
self是单次声明式配置解析器的实例对象(DeclarativeConfig.new())。每次发生 Reload(如/config重新下发),Kong 都会为该轮 Reload 重新创建全新的解析器实例,并传入当前最新的插件集self.plugin_set,因此不会串读到上一轮的旧 Schema。单次 Reload 完成后,self失去引用即进入待 GC 状态。
维度二:高频 Reload 下,内存泄漏的风险是否彻底根除了?
- 局部解决了“单次解析暴击”,但不能杜绝“高频并发 Reload 累积泄漏”:
- 对象释放滞后与闭包挂载:如果外层的事件监听器、定时器或 Worker 间通信模块(如上述的
events.lua闭包问题)在配置解析后,无意持有了新生成实体或解析上下文的强引用,那么即使单次构建次数降到了 1 次,只要在 K8s 环境下存在 CI/CD 或 Ingress Controller 每秒多次的高频推送,成百上千份历史配置的 Schema 与 Entity 依然会无法被 GC 回收; - GC 吞吐率瓶颈:极高频的 Reload 会在短时间内产生巨大的短期对象堆积,当分配速率超过 LuaJIT GC 的吞吐上限时,Worker 内存依然会持续走高。
- 对象释放滞后与闭包挂载:如果外层的事件监听器、定时器或 Worker 间通信模块(如上述的
- 架构级终局解法:正因如此,Kong 在后续架构(如 3.x 时代)逐步推进将核心配置全量沉降至共享内存/嵌入式 LMDB 引擎中,彻底解耦 Worker 进程的 Lua 堆与配置实体生命周期,从根源上消除了高频 Reload 带来的 GC 颠簸。
C 内存火焰图的深度佐证:ngx_http_lua_create_fake_request
在这张 C 内存分配火焰图中,最宽的一条调用栈恰恰直接暴露了问题的本质:
- 占比高达 40.92% 的核心热点:
ngx_process_events_and_timers$\rightarrow$ngx_event_timer.c$\rightarrow$ngx_http_lua_timer_handler$\rightarrow$ngx_http_lua_create_fake_request(占了近 300KB 的单次采样分配)。 - 为什么这里会有
create_fake_request? 在 OpenResty 的底层实现中,Nginx 原本的所有上下文都是围绕一次真实的客户端 HTTP 请求(ngx_http_request_t)构建的。但在 Kong 的后台定时器(ngx.timer.at/ 负责拉取配置与事件分发的后台轮询任务)执行时,并没有真实的 HTTP 请求接入。为了让 Lua 代码能正常使用ngx.var、日志输出及各类 PDK API,OpenResty 必须在 C 层为每个 Timer 虚构一个伪请求对象——即create_fake_request及配套的内存池ngx_create_pool。 - 双向印证问题所在:
这张火焰图雄辩地证明了:C 层的常驻分配热点几乎全部是由 Lua 层的后台定时器(
timer_handler)高频驱动伪请求创建所引起的;Nginx 原生的网络读写、SSL 握手(ssl3_read仅占 2.3%)和自身基础设施完全处于正常水位。这强有力地佐证了:系统根本没有发生 C 层的原生内存泄露,所有内存压力的源头都在 Lua 层的 Timer 闭包调度与配置事件重载机制中。
核心调优与生产防范原则
- 关注官方核心补丁与元数据缓存治理:及时升级或向后移植官方修复补丁(如修复
events.lua与clustering.lua中事件订阅闭包未解绑缺陷,避免将临时闭包注册进全局事件表); - 监控
lua_shared_dict命中与淘汰率:通过 Prometheus 密切监控kong_memory_lua_shared_dict_bytes与各 Worker 的kong_memory_workers_lua_vms_bytes,配置容量增长斜率告警; - 生产环境开启 Worker 定期优雅轮换:对于超高并发或频繁动态切流的生产网关,可在
kong.conf中为 Worker 进程配置合理的主动重载阈值,作为极端环境下的最后一道安全防线。
拓展延伸:去中心化网关的参考实现(MTOP 方案:A-Server + VIPServer + 泛化调用)
在微服务通信与网关演进中,除了以 Kong 为代表的「中心化反向代理网关」和以 Istio 为代表的「Service Mesh Sidecar 模式」之外,业界在大规模、超高并发内部微服务调用场景下,还发展出了一种极具代表性的工业级方案——MTOP 去中心化网关方案(以阿里无线移动开放网关 MTOP 早期演进为典型代表:A-Server / 接入层容器 + VIPServer/Nacos 软负载 + HSF/Dubbo 泛化调用)。
架构运行机理(MTOP 模式)
该方案摒弃了传统的中心化代理层,将网关寻址和转发逻辑下沉到调用方本地进程:
                              ┌───────────────────────────┐
                              │ VIPServer / Nacos 注册中心 │
                              │   (仅作控制面: 寻址与健康)   │
                              └─────────────┬─────────────┘
                                            │ 异步订阅/缓存地址簿
                                            ▼
┌─────────────────────────────────────────────────────────┐
│                      A-Server (调用方)                  │
│                                                         │
│  [业务/网关聚合逻辑]                                    │
│          │ 传入接口名、方法名、参数 JSON                │
│          ▼                                              │
│  [RPC 泛化调用 SDK] ──(本地路由/同机房优先)───┐          │
└───────────────────────────────────────────────┼─────────┘
                                                │
                                  直接建立 TCP 连接 (Zero-Hop)
                                                │
                        ┌───────────────────────┴───────────────────────┐
                        ▼                                               ▼
          ┌───────────────────────────┐                   ┌───────────────────────────┐
          │  后端机器节点 1 (Provider)  │                   │  后端机器节点 2 (Provider)  │
          │   (反射 / 字节码反序列化)   │                   │   (反射 / 字节码反序列化)   │
          └───────────────────────────┘                   └───────────────────────────┘
- 软负载寻址(VIPServer / Nacos 控制面):
- A-Server 启动时或周期性向 VIPServer 订阅下游服务的机器 IP 列表与健康状态,并在本地内存做地址簿缓存与就近/权重负载均衡计算;
- 数据流完全不经过注册中心,VIPServer 纯粹作为控制面,不产生任何数据转发开销。
- 泛化调用(Generic Invoke):
- 传统的 RPC 调用要求客户端强依赖服务端的 API 二方库(Jar 包)与 DTO 模型类;
- 在网关/通用代理(A-Server)场景下,通过 RPC 泛化调用接口,A-Server 无需引入任何下游接口的二方包;
- 仅需动态传入目标接口全限定名(
serviceName)、方法名(methodName)、参数类型列表(paramTypes)以及实际参数值(args,通常为 Map 或 JSON 结构); - 服务端节点在接收到底层请求后,通过反射或字节码生成技术在本地完成参数反序列化并派发给对应实现类。
三种典型网关/服务通信范式对比
| 架构范式 | 代表技术方案 | 数据链路模型 | 适用业务场景 | 核心瓶颈与挑战 |
|---|---|---|---|---|
| 中心化网关 | Kong, APISIX, Spring Cloud Gateway | Client $\rightarrow$ 网关反向代理 $\rightarrow$ 后端服务(双跳) | 南北向公网接入、OpenAPI 开放平台、WAF 安全防护、异构语言统一入口 | 网关集群易成性能瓶颈与爆炸半径核心;增加网络跳数与延时 |
| 去中心化 SDK 直连 | VIPServer/Nacos + HSF/Dubbo 泛化调用 | A-Server $\rightarrow$ 目标机器(单跳真·直连,Zero-Hop) | 内部东西向超高并发、超低延时、单一语言栈(如全 Java)的微服务骨干交互 | 强绑定单一语言 SDK、跨团队推动 SDK 升级治理成本极高、无法直接防御公网不可信流量 |
| 去中心化 Sidecar (Mesh) | Istio, Envoy, MOSN | Service A $\rightarrow$ Sidecar A $\rightarrow$ Sidecar B $\rightarrow$ Service B | 多语言异构集群东西向互通、零侵入治理、金融级 mTLS 加密与流量切分 | 资源底噪(CPU/内存开销)较大、网络拦截存在额外时延损耗、分布式调试排障复杂度高 |
生产架构演进启示
去中心化网关在大促高并发、内部系统、单一核心技术栈下具备无与伦比的性能和成本优势;但在面对公网不可信流量、跨异构多语言组织协同时,中心化 API 网关(如 Kong)在边缘安全合规、协议清洗、动态插件拦截上的防线作用依然无可替代。
业界主流的成熟实践通常走向分层融合:
- 外部边界:部署 Kong 等中心化网关阻挡公网流量,统一完成 WAF 拦截、TLS 卸载、OAuth2/JWT 鉴权与协议转码;
- 内部核心:网关或前置服务将流量转入内部后,通过 VIPServer 软负载寻址及 RPC 泛化调用(或 Service Mesh)直连底层服务节点,兼顾公网安全性与内部调用的极致吞吐。